提交即表示你同意我们使用你留下的信息,仅用于本次咨询对接。
服务器、交换机、虚拟机、容器、云主机……分散在好几个平台,没有统一的地方能一眼看全。
半夜收到 50 条告警,到底是网络问题还是磁盘满了?翻 Zabbix 看半天才知道是 PGSQL 连接没释放。
周报月报从 Zabbix 导数据、贴 Excel、发邮件,一个报告做半天,格式还不统一。
VMware 一套监控、阿里云一套、K8s 又一套,出了问题不知道该看哪个平台。
监控发现问题 → AI 分析问题 → Agent 解决问题,三步闭环,不靠人盯着。
Enterprise Monitoring Platform
不是开源 Zabbix 装完就丢给你。我们做了全面汉化、模板标准化、分布式 Proxy 架构、高可用部署,开箱即用,支持 10 万+设备。私有云、公有云、物理机、虚拟机、容器全覆盖。
AI-Powered Operations
对接 Zabbix 告警数据,AI 自动分析根因、自动生成巡检报告、自动触发故障自愈。日报/周报/月报全自动分发,常见故障秒级处理,不用再安排人半夜值班。
Natural Language Operations
用飞书/钉钉/企业微信给机器人发一句话,「查一下数据库服务器 7 天的 CPU 趋势」,OpenClaw 自动从 Zabbix 拉数据、算指标、出图表。运维也能用自然语言干活。
监控项、触发器、标签、主机组、模板,所有指标从英文全部汉化,命名规范统一。新人第一天就能看懂,不用查字典猜含义。
Zabbix Server HA 双活部署,7×24 全天候运行,自动故障切换,零数据丢失。不是「挂了等人修」,是挂了自动切到备机。
多厂区、多园区场景下部署 Proxy 节点,本地采集 + 中心管理。组件之间原生加密通信,跨地域也不怕数据泄露。
日报/周报/月报自动生成、自动分发。管理层看系统健康度,运维看性能趋势,审计看合规记录,同一份数据,不同维度呈现。
自研告警大屏 + IT 运维总览大屏,面向值班室和管理层投放。数据来自 Zabbix,界面是我们的,不是开源软件自带的图表。
支持超过 100,000 台设备的超大型环境。分布式架构确保在大规模场景下依然稳定,不会设备一多就卡。
不是只能监控物理机。虚拟化、容器、私有云、公有云、混合云,每个平台都有对应的采集方案。
VMware vSphere
vSphere API 直连,监控 ESXi/vCenter 宿主机、虚拟机、存储集群
Microsoft Hyper-V
PowerShell 采集宿主机与虚拟机 CPU、内存、磁盘、网络
Nutanix AHV
Prism API 采集超融合 CVM、虚拟机、分布式存储 IO
Docker
Docker API 自动发现容器,监控资源占用、启停状态
Kubernetes
K8s 标准 API,监控节点、Pod、容器、控制平面健康度
OpenStack
原生 API 监控计算节点、云主机、块存储、租户资源
阿里云
开放 API 采集 ECS、ACK、OSS、RDS 性能与告警
华为云
SNMP + API 纳管计算、存储、网络资源
AWS
CloudWatch 接口采集 EC2、EKS、RDS、S3 性能
Azure
Azure API 纳管云主机、AKS、存储负载与配额
GCP
GCP 监控 API 纳管 GCE、GKE、云存储
H3C 云平台
CVK 虚拟化节点、分布式存储、虚拟网络
深信服 SCP
SCP 平台监控虚拟化节点、分布式存储、虚拟机
Proxmox VE
Proxmox API 采集节点、LXC、QEMU 虚拟机
本地虚拟化
API/自定义脚本采集本地虚拟化实例资源与状态
更多平台
支持 SNMP、IPMI、JMX、自定义脚本接入任意设备
Zabbix 原生界面是给运维工程师看的。这两块大屏是给我们的客户,管理层、值班室、大屏投放,用的。数据来自 Zabbix,界面是我们自研的。
投在值班室墙上的那块屏。所有严重告警实时弹出、声光报警,运维不用盯着 Zabbix 后台刷页面。管理层路过也能一眼看到今天系统稳不稳。
给管理层和 IT 总监看的全局视图。纳管多少设备、可用率多少、当前有几个严重告警、出口带宽跑多高,一块屏讲清楚 IT 全局。
光电科技 · 多站点制造
昆山、苏州、越南 3 个站点的 Oracle 数据库实例实时纳管在一块屏上。DBA 不用逐站登录,打开大屏一眼看到全貌。
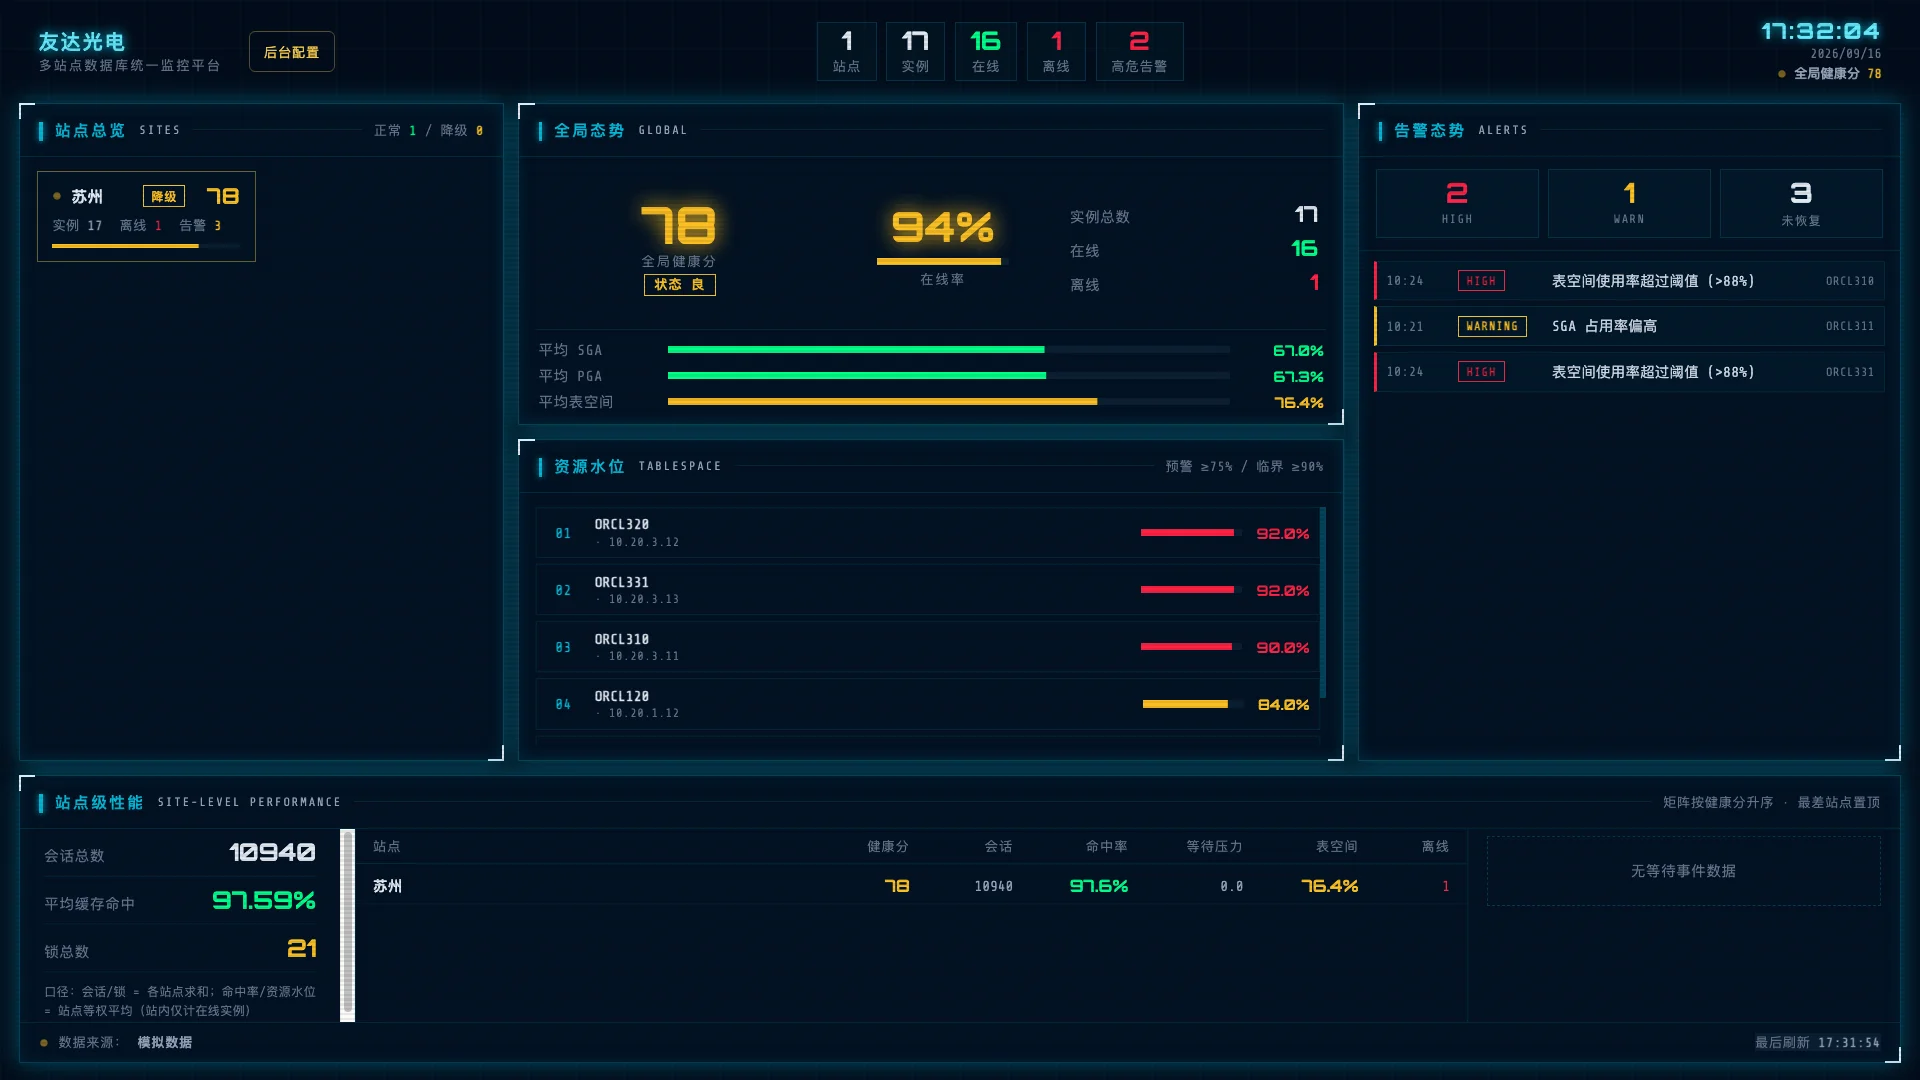
半导体 · 统一监控 + 运维大屏
洁净室环境、MES 系统、PLC 控制器、服务器集群,之前各自独立,出了问题产线停了才知道。现在统一纳管,运维总览大屏投放中控室。
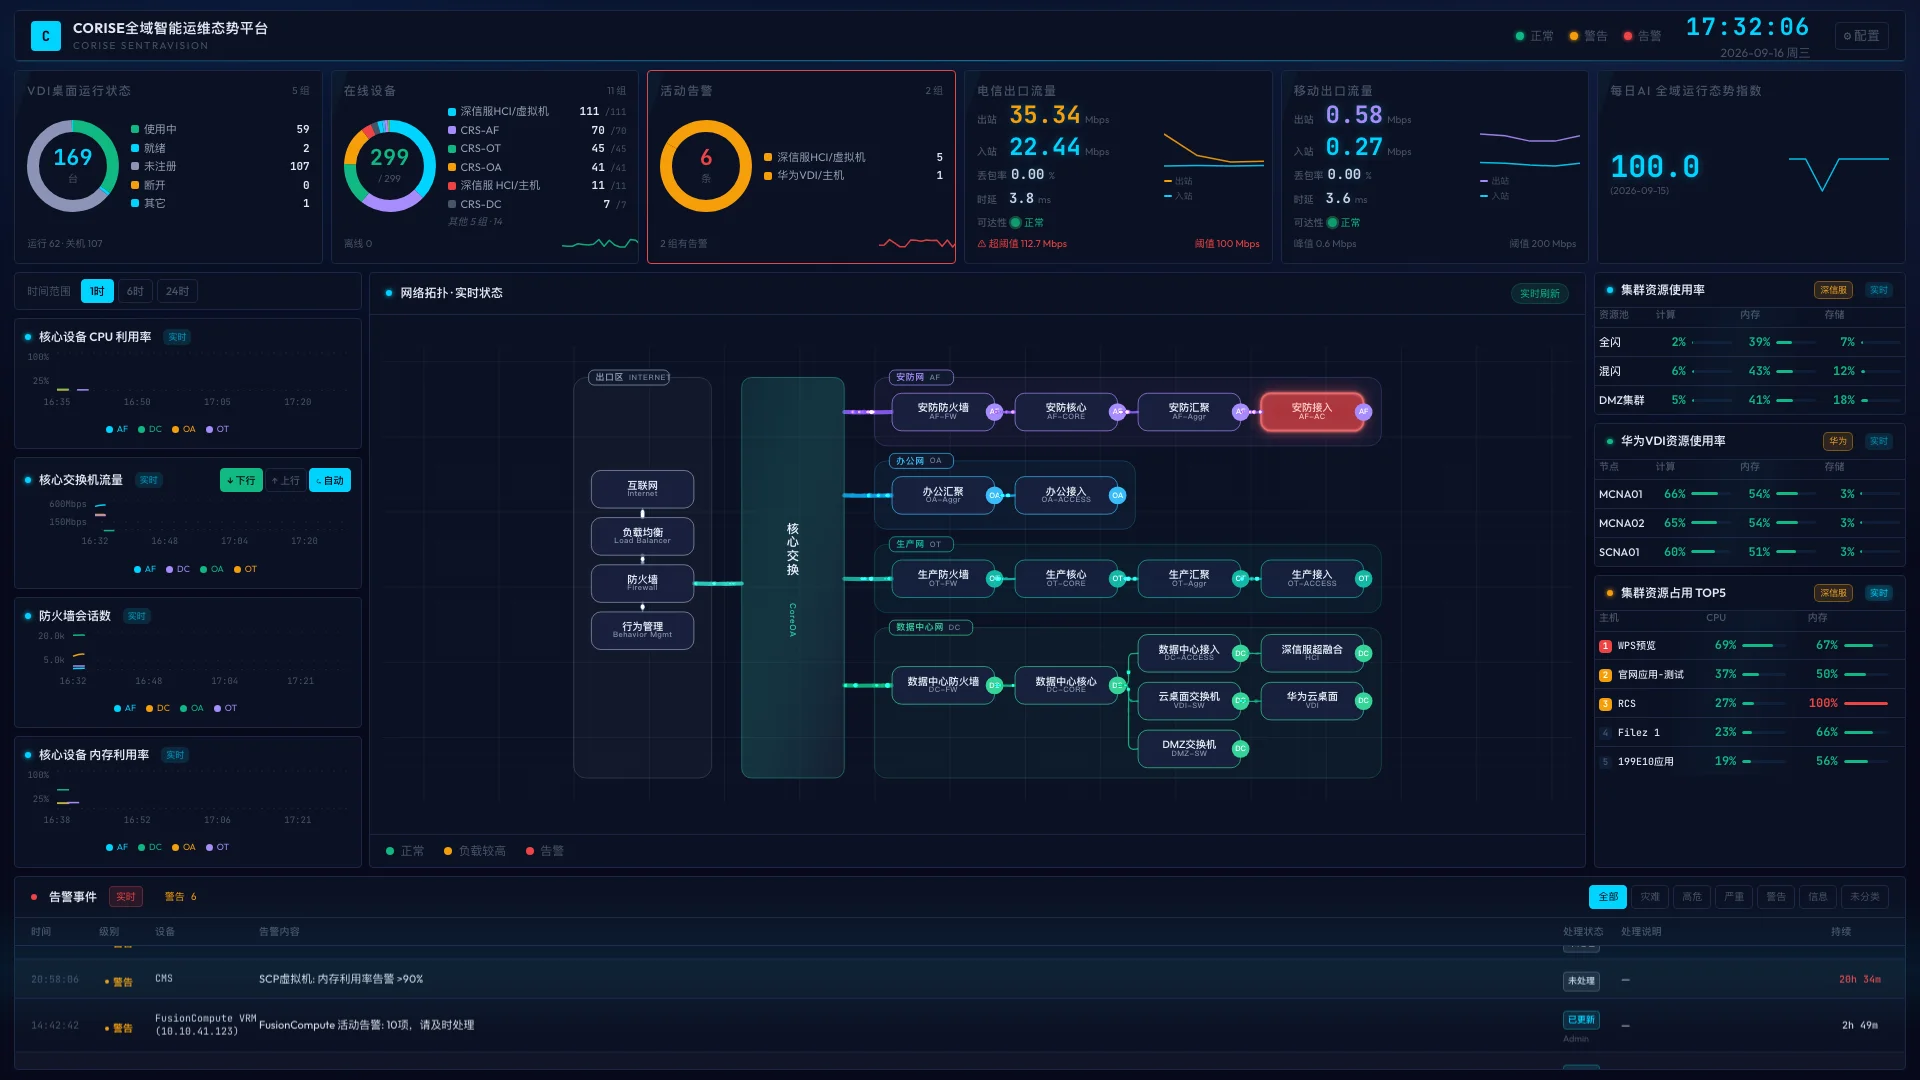
光电科技 · 多站点制造
半导体 · 统一监控+运维大屏
AIOPS 对接 Zabbix,把监控数据变成可执行的运维动作。人在睡觉,系统在干活。
替代人工,全量覆盖监控平台纳管的所有资产,生成标准化巡检报告。不用安排人每天登录 Zabbix 一项项检查。
日报/周报/月报自动分发到邮箱或飞书/钉钉群。管理层看健康度,运维看趋势,合规审计看日志,各取所需。
自动处理 70% 以上常见故障,磁盘满了自动清日志、服务挂了自动重启、证书到期自动续签。处理时长从小时级缩短到秒级。
基于历史数据预测资源瓶颈和风险,提前 7-30 天预警。不用等磁盘 99% 了才收到告警,85% 的时候就知道要扩容了。
自动识别闲置虚拟机、低利用率存储、过期证书。该扩的扩,该回收的回收,IT 成本降 10-30%。
核心业务 7×24 小时不间断巡检,快速发现并定位故障。不依赖人值班,系统自己盯着,出问题秒级响应。
Zabbix 触发告警后,OpenClaw 自动登录目标主机排查,精准定位根本原因,能自动修复的直接修,不能修的给出操作指引。不是告诉你「磁盘告警了」,是告诉你「PGSQL 空闲连接没释放导致内存高,已清理,建议加连接超时配置」。
发一句话,「统计数据库服务器 7 天的 CPU 利用率趋势图」,OpenClaw 自动从 Zabbix 拉数据、算均值/峰值、生成可视化图表。不用打开 Zabbix 后台一项项配筛选器。
支持飞书、钉钉、企业微信等多种交互渠道。运维人员在日常使用的 IM 工具里直接和机器人对话,不用切换平台。告警推送、指令下发、报表接收,都在一个窗口完成。
Zabbix 触发「磁盘使用率 >90%」→ OpenClaw 自动清理日志 → 推送处理结果到飞书群。时间同步类告警直接自动修复,不用人介入。从告警到闭环,全程无人值守。
Zabbix 负责「看」,AIOPS 负责「想」,OpenClaw 负责「做」。三个产品各管一段,合在一起就是完整的智能运维闭环。